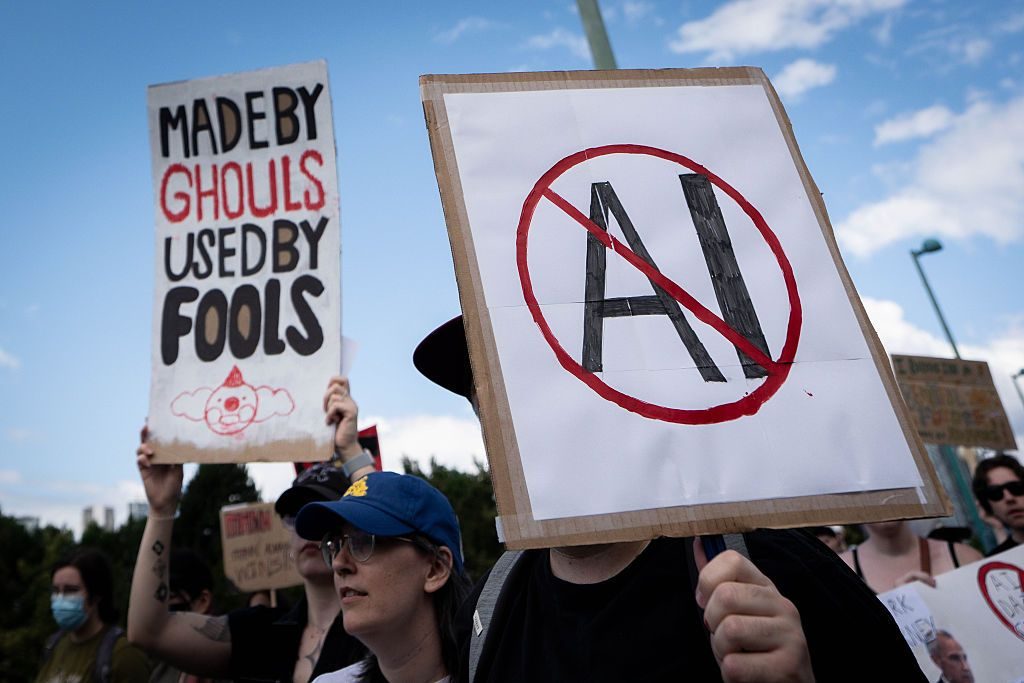
微软 AI CEO Mustafa Suleyman 公开主张,人类无权创造“数字物种”,即便技术做得到。这是今天最值得看的一条,因为它把 AI 争论从“能不能”推到“该不该”,而且出自前沿实验室高管之口。有意思的是,同一批新闻里,Apollo 首席经济学家说绝大多数企业从 AI 拿到的是零财务回报。一边在伦理上踩刹车,一边在财务上空转,这两件事同时成立,才是当下 AI 的真实处境。
微软 AI 负责人:做得到,也不该造有意识的机器重要性 6/10
Mustafa Suleyman 主张 AI 应保持无意识状态,即便技术上可行,也不应研发有意识的机器。他把这件事定性为“堪比哥白尼时刻的文明级事件”:哥白尼把人类从宇宙中心挪开,而造出有意识的机器,会把人类从“唯一的意识主体”这个位置上挪开。
关键点不在于技术路线,而在于他给出了一个“有能力也不做”的先例。当下的 AI 治理讨论多集中在风险控制,比如幻觉、滥用、失控;Suleyman 把它推到了本体论层面:争论的不是模型会不会伤到人,而是人类该不该成为意识的创造者。
这类主张不会很快变成监管条文,但它会持续影响前沿实验室的自我设限叙事。当“不做什么”开始被当成立场公开表达,行业默认值的边界就在移动。
原文:36氪
Apollo:多数企业的 AI 回报是零重要性 6/10
Apollo 首席经济学家给当前的 AI 投资热度泼了一盆冷水:绝大多数企业尚未从 AI 获得可量化的财务收益。
要注意限定词,是“多数”而非“全部”,是“可量化”而非“有价值”。这两处保留恰恰说明了问题所在:AI 带来的改善可能真实存在,但难以归因、难以计量,于是进不了损益表。
为什么重要:企业采购决策需要一个能对内交代的理由。在“卡位”阶段,理由可以是“不能落后”;到了下一轮预算周期,理由必须变成“省了多少、多赚了多少”。如果这条线迟迟画不出来,叙事就会从投入转向清算。这也是今天所有 AI 产品经理都该自问的一句:你卖出去的东西,客户能用什么指标写进汇报材料?
原文:TechCrunch
Jepsen 的警告:LLM 正在侵蚀“可信”本身重要性 5/10
Kyle Kingsbury 在对 ParticleDB 1.1.4 的分析中指出,LLM 生成内容的泛滥正在系统性削弱人们对文档与软件产出的信任。Jepsen 系列分析一贯的做法是不采信文档、只采信可复现的测试,这一方法论在今天反而成了预言。
关键点在于信任危机的性质变了。过去的信任问题是“厂商夸大了能力”,可以通过第三方测试来纠正;现在的问题是内容本身难以判断来源与真伪,连“谁写的、有没有验证过”都说不清。
为什么重要:软件供应链建立在大量低成本的信任信号上——文档、changelog、issue 回复、示例代码。一旦这些信号被稀释,验证成本就会转移给下游每一个使用者。对做基础设施和开发者工具的团队来说,这既是负债,也是机会:可验证性本身正在变成卖点。
原文:Jepsen
苹果的克制:不为 AI 而 AI重要性 5/10
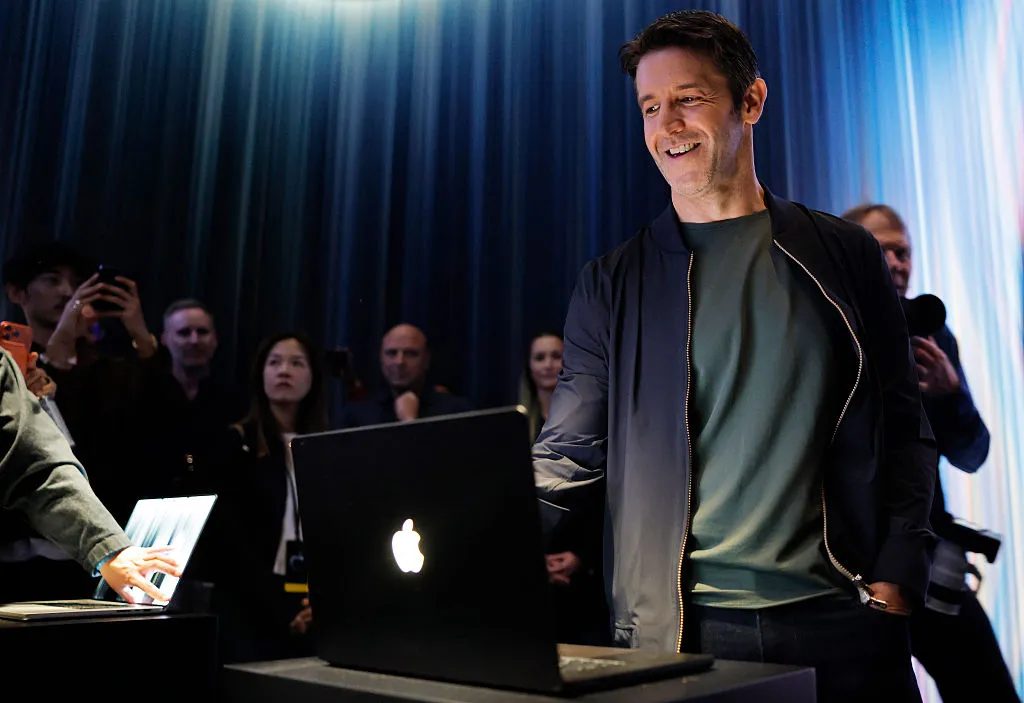
苹果 CEO 为公司在新一轮 AI 竞赛中的克制做出辩护,明确表示不会为了贴上 AI 标签而发布功能。
关键点是他反驳的其实是“功能清单式 AI”:把 AI 当成发布会上的一个词,等于把模型的不确定性直接推给用户。这种克制在短期看是落后,在产品线上看是纪律——不发布,就不用为不该发布的体验负责。
为什么重要:这与 Suleyman 的“有能力也不做”形成呼应,但动机完全不同,一个是伦理红线,一个是产品标准。更现实的一层是,在 Apollo 那份“零回报”的判断背景下,克制的成本正在下降。当所有人都在证明自己用了 AI,讲清楚“我们不用在哪儿”反而更容易被听懂。
原文:TechCrunch
徒步者与聊天机器人:判断力外包的代价重要性 5/10
Wired 报道,把路线规划外包给 AI 会让徒步者放弃独立判断,在荒野中可能酿成致命后果。
关键点不是模型答错了,而是人不再做最后一道校验。这与自动化偏见(automation bias)是同一套机制,只是代价从“点错一个按钮”升级成“走进一条不该走的路”。
为什么重要:在 agent 产品设计里,“给建议”和“替用户决定”之间的边界,在低风险场景里可以模糊,在物理世界则不行。做消费级 agent 的团队应该把“什么时候必须让人确认”当成与模型选型同等重要的设计问题——尤其是在没有撤回键的场景里。
原文:Wired
50 个 agent 建城,败给了官僚主义重要性 4/10
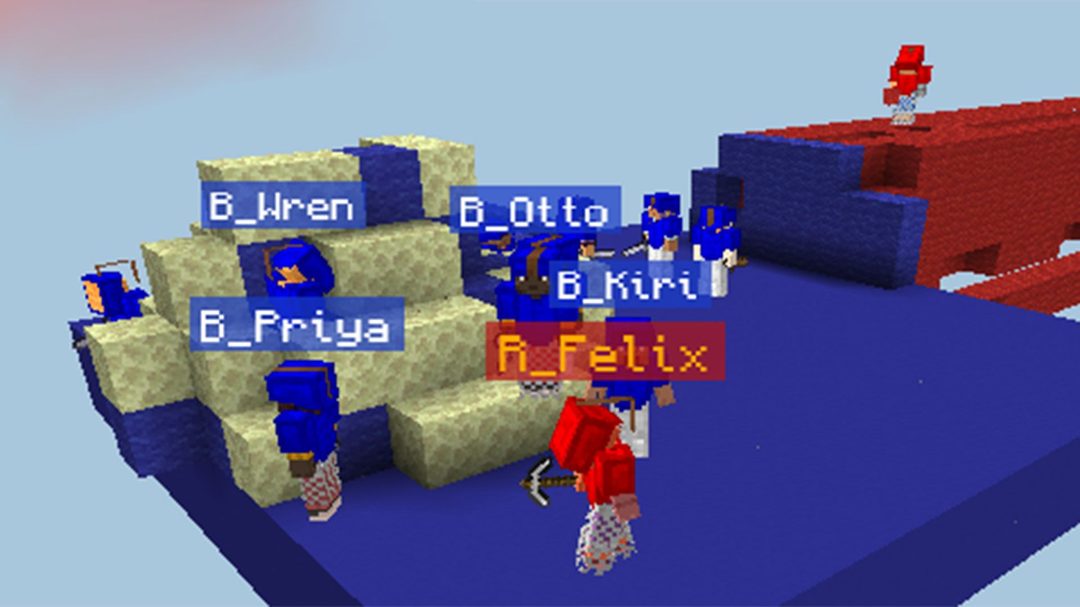
Tom's Hardware 报道的一项实验,让 50 个 agent 组成的团队在《我的世界》里协作建城,结果陷入无止境的流程与内耗,未能形成有效分工。
关键点在于失败位置:不是单体 agent 能力不够,而是协调机制失效。agent 越多,用于对齐、汇报、互相审批的轮次就越多,真实产出被挤压。这和人类组织得的病是同一个病。
为什么重要:多 agent 系统的瓶颈往往在协议层而非模型层。对做 agent 编排的团队,这条实验值得记住的地方是:增加 agent 之前,先想清楚谁有权做决定、什么情况下可以跳过流程。没有授权结构的并行,只是把单点延迟换成了系统性延迟。
原文:Tom's Hardware
当模型能读二进制,混淆还挡得住吗重要性 4/10
InfoQ 一篇长文讨论:随着模型反编译能力增强,闭源软件依靠二进制混淆建立的壁垒正在被削弱。
关键点在于护城河的迁移方向。过去闭源软件的一部分溢价来自“看不懂”,现在“看懂”的成本在被模型快速折价。但可读的代码并不等于可维护的系统——编译产物能还原出逻辑,还原不出团队的工程经验、运维积累和多年踩过的坑。
为什么重要:对创业者而言,“把东西藏起来”正在从策略退化为习惯。真正需要想清楚的是:如果竞争对手明天就能读到你的全部逻辑,你还剩什么理由被选择?答案通常不在代码里。
原文:InfoQ
跨天级金融 agent:记忆与自建 harness重要性 4/10
Latent Space 访谈 Arca AI 负责人,讨论跨天级金融 agent 的三个工程命题:持久记忆、自建 harness,以及能持续数天的 agent 工作流。
关键点在于要求变了。金融场景对 agent 的期待不是“更聪明”,而是“可中断、可恢复、可审计”——一个跑几天甚至更久的任务,必须有状态写入磁盘、有明确的人工接管点、有事后可复盘的操作轨迹。
为什么重要:这正是 agent 从 demo 走向生产的分水岭。单轮能力已经够用,长周期任务的可靠性还远远不够。Arca 选择自建 harness 而非依赖通用框架,本身就是一个信号:现有通用框架还托不住这类负载,愿意为此重写基础设施的团队,暂时拿到了别人拿不到的稳定性。
原文:Latent Space
今天这八条,其实在问同一个问题:AI 该在多大程度上替我们做决定——从意识,到预算,到一条徒步路线。留一个问题给你:你所在的团队,今年能从 AI 里拿出可量化的那一笔吗?