今天最值得关注的动态是:OpenAI 称 GPT-6 Astra 配合 Codex,在不到一周内完成了一款硬件设备从概念到 CAD、PCB 与仿真的设计。这个说法的重点在于交付周期被压缩到一周,而非“AI 会画图”本身。硬件行业的节奏由模具、打样、改版和认证等环节决定;如果其中任何一段能被压缩到天级,产品定义的方式都会随之改变。今天另外三条消息也在讲同一件事的不同侧面:模型开始携带可验证的身份,开始自带科学领域的训练数据,也开始适应语音这种双向通道。
GPT-6 Astra:一周走完硬件设计流程重要性 9/10
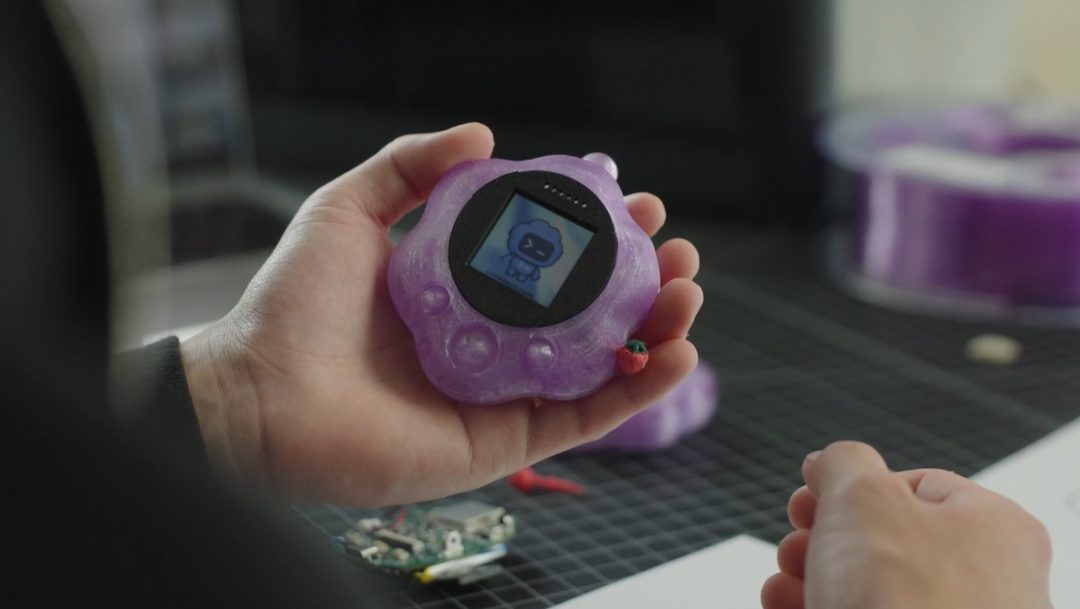
据 OpenAI 的说法,GPT-6 Astra 与 Codex 配合,在不到一周内完成了一款硬件设备从概念到设计的全过程,覆盖 CAD 建模、PCB 设计与仿真等工程环节。
关键点在于流程覆盖范围,而非生成单个零件:CAD、PCB、仿真通常由不同工具、不同角色接力,跨工具链路正是 agentic 系统最容易中断的地方。如果这条流程真能端到端走通,就意味着模型不只相当于一个会画图的实习生,还能充当一个能自行串联工程流程的执行者。
为什么重要:硬件迭代的真实成本集中在“设计—打样—发现问题—改版”的循环上。把设计侧周期压到一周,受影响最大的是早期概念验证与小批量产品;不过,样机验证和量产良率仍取决于物理世界。OpenAI 目前给出的是自述,缺少第三方复现,因此判断应停在“流程可行性被展示”这一步。
原文:The Decoder
FlashProve:为模型回复加上密码学身份证明重要性 7/10
Anthropic 公布了一个名为 FlashProve 的原型,基于 zkSNARK,能在不暴露模型权重的前提下,证明某条回复确实由声明的模型生成。单张 H100 上验证 Llama 4 Maverick,证明体积 19MB。
关键点有两个:一是零知识证明把“模型身份”从厂商声明变成可验证事实;二是 19MB 的证明体积和单卡验证成本,已经进入工程上可以讨论的范围,不再只是理论演示。
为什么重要:模型来源认证是 agent 大规模接入生产系统的前提条件。当 API 调用方需要向审计、合规或下游用户证明“这条输出确实来自我声明的模型”时,密码学证明比日志和签名更有说服力。待解的问题是验证延迟与成本能否随调用量摊薄,以及这套机制能否扩展到专有模型。
原文:TechCrunch
Hydrogen-1.0:753B 开源科学模型重要性 6/10
Deep Principle 发布 Hydrogen-1.0,参数规模为 753B,基于 GLM-5.3 后训练,面向化学、材料与生命科学,采用开放权重。训练数据包含实验室记录与智能体发现轨迹。
关键点在数据构成:实验室记录属于典型的非公开、低结构化数据;智能体发现轨迹则把“如何探索”的过程也变成训练信号,而不只是最终结论。这种组合比单纯增加论文语料更接近科研实际工作流。
为什么重要:科学领域的开源权重模型此前多集中在推理基准上,很少触及真实实验数据。如果开放权重能落在这一量级,高校与中小实验室就获得了可审计、可微调的基础模型。需要观察的是权重开放程度、许可证限制,以及在标准科学基准上的独立评测结果。
原文:MarkTechPost
Soniox STT v6:让语音 Agent 边听边说重要性 4/10
Soniox 发布语音识别 API 的 v6 版本,新增回声消除,以及“读取 Agent 自身输出”的能力,专门针对语音助手的短回答与打断场景优化。
关键点在于,它把 Agent 自己的 TTS 输出也纳入 ASR 的上下文。语音助手最大的工程难点是设备在播放自己的声音时仍在收音,导致识别结果混入回声;把自身输出交给识别端,等于让模型知道“哪些声音是我说的”。
为什么重要:语音是少数必须全双工交互的接口,打断和抢话是常态。此前这类处理多由终端侧 AEC 或应用层拼接完成,现在下沉到 ASR 供应商,语音 Agent 的接入复杂度会明显下降。这一条的重要性在工程层,而非能力层。
原文:MarkTechPost
模型能力正在三个方向同时“接地”:接入工程工具链、携带可验证身份、对齐真实世界的输入通道。留给读者一个问题:当模型能自证身份,也能自行走完设计流程,你所在团队的验收环节准备好了吗?