今天这个板块有 8 条,最值得看的不是谁登顶榜单,而是一条尚未获官方确认的报道:GPT-6 Astra 被指能在权重层面「编程」其他模型。如果这个描述站得住,模型的能力边界就从「调用工具」挪到了「改写工具本身」,而这正是现有安全与治理框架最没准备好的地方。同一时间,腾讯把 Hy4 的视觉理解和 0.3 元/百万 tokens 的输入价一起放了出来,国内开源这条线的竞争已经打到成本结构上,而不只是跑分。
腾讯混元 Hy4:视觉理解 + 0.3 元定价重要性 8/10
腾讯发布混元 Hy4,首次引入视觉理解能力,可操作电脑完成跨应用任务,官方称其综合表现跻身最强开源模型之列。模型已上线腾讯云 TokenHub,输入价格低至 0.3 元/百万 tokens,限时最低 2.5 折。
关键点在两处。一是能力方向:视觉理解加电脑操作,指向的是 GUI agent 这类需要「看懂屏幕再动手」的任务,而不是单纯的图文问答。二是价格:0.3 元/百万 tokens 配合限时折扣,把视觉推理的调用成本压到了几乎可以忽略的量级。
为什么重要:开源模型的竞争重心正从参数规模转向 agentic 落地能力,而落地的前提是成本足够低、试错足够便宜。对做 GUI agent、RPA 替代的团队来说,这是一个可以直接重算成本模型的变量。视觉能力本身并不稀奇,稀奇的是它和这个价格同时出现。
原文:36氪
OpenAI Images 2.6:更快、能出 GIF、可局部编辑重要性 8/10
OpenAI 发布 Images 2.6,带来更快的图像生成、GIF 创作与更精准的局部编辑,并新增 API 控制项,已同步接入 ChatGPT、Codex 与 API。
三个变化各有指向:生成速度影响交互体验;GIF 意味着从静态图走向短动态内容;局部编辑的精度决定了它能否进入真实的设计修改流程,而不是只做一次性出图。新增的 API 控制项则说明它被当作可编程组件,而非只面向终端用户的功能。
为什么重要:图像模型正在从「生成一张图」变成「嵌进工作流的一环」。接入 Codex 这一条尤其值得注意——当写代码的 agent 能顺手生成和编辑图像,素材生产就被拉进了开发流程内部。对产品团队来说,评估的重点应从出图质量转向「可被调用、可被反复修改」这两项工程属性。
原文:OpenAI
GPT-6 Astra 两项爆料:改他模权重、一周造硬件重要性 8/10
据 The Decoder 报道,GPT-6 Astra 能直接通过权重层面「编程」其他模型,并在不到一周内从零设计出一款硬件设备。目前没有官方确认,属于媒体报道层面的信息。
如果描述成立,这两件事的性质不同但方向一致:前者是把别的模型当作可修改的对象,后者是把「设计—验证」的周期压缩到以天计。前者触及能力边界,后者触及工程节奏。
为什么重要:模型直接改写其他模型的权重,意味着能力的分发和复制可能绕开现有的授权与审查路径,安全讨论里常见的「模型权重不可外流」这类假设会变得脆弱。同时也需要对单一来源的转述保持距离——这类爆料的验证成本很高,传播速度却很快。判断可以留到有可复现证据时再下。
原文:The Decoder
Gemini 4 Carbon 登顶榜单,谷歌市值反而承压重要性 6/10
Gemini 4 Carbon 在评测榜拿下第一,但有报道称其「速成」背后是谷歌的一场豪赌,发布后公司市值明显承压。
两件事在时间上重合:榜单第一,与资本市场的负面反应。报道把后者读作这场豪赌的代价,但榜单成绩与市值波动之间的因果并未被证实,不宜简单归因。
为什么重要:这是「榜单第一」解释力衰减的又一个样本。当评测排名与商业信心出现背离,说明市场在意的已经不只是模型能力,而是拿到这个能力付出了多少、能不能持续。对做模型评估的人来说,一个可用的判断是:单一榜单的排名正在从结论变成线索,需要配合成本、迭代速度和交付形态一起看。
原文:雷峰网
GPT-5.6 Cyber 经 AWS GovCloud 向授权客户开放重要性 6/10
Daybreak Red 通过 Amazon Bedrock 在 AWS GovCloud(美东)向获批客户提供 GPT-5.6 Cyber,面向合规网络安全作业场景。
要点在交付路径而非模型本身:不是公开 API,而是经由云厂商的政府云区域、面向获批客户开放,场景限定在合规的网络安全作业。
为什么重要:前沿模型的分发正在沿着合规边界分层。同一家公司的模型,会同时存在面向公众的版本和面向政府与受监管行业的版本,两者的渠道、客户资格和用途限制完全不同。这条线对投资人是一个独立赛道——模型能力的政府采购渠道,其竞争逻辑与消费级 API 市场并不相同,壁垒更多来自资质与部署形态。
原文:OpenAI
Ripple-65B 预览版开源:终端任务得分 80.5重要性 5/10
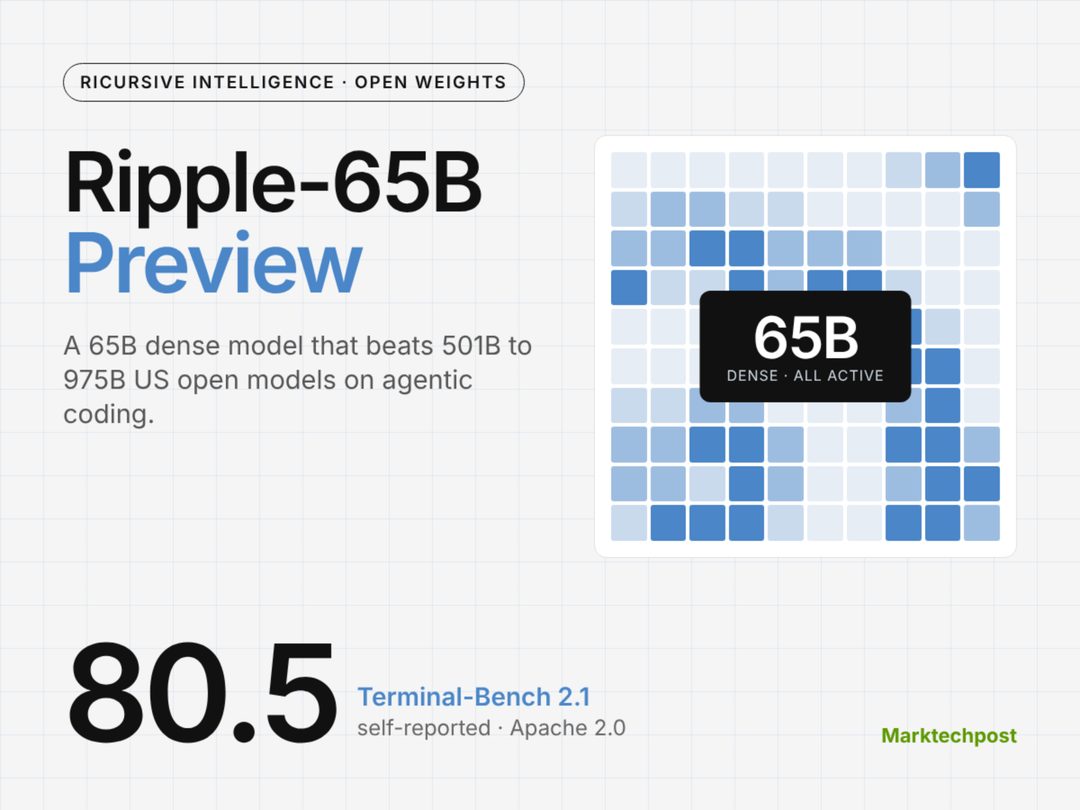
Ricursive 发布 Apache 2.0 许可的 65B 稠密开放权重模型 Ripple-65B Preview,Terminal-Bench 2.1 得分 80.5,报道称其领先体积最高达其 15 倍的美国开源模型。
两个细节值得留意:一是稠密(dense)架构而非 MoE,部署与推理行为更容易预测;二是主战场选在终端任务,这是当前开源模型竞争最集中的考核项。
为什么重要:用 65B 打赢体积更大的对手,说明后训练与任务对齐的收益在这类操作性基准上仍然很高,参数规模不是唯一变量。对自建推理的团队,稠密 65B 在显存与吞吐上的可规划性是一项实际优势。不过 Terminal-Bench 只覆盖一类能力,不能外推到通用对话或长上下文任务。
原文:MarkTechPost
webAI 发布 TwIL-8B:MATH-500 得 98.2重要性 5/10
webAI 发布 TwIL-8B,一个基于 IBM Granite 4.2 8B 后训练的 8.8B 推理模型,数学与代码基准表现亮眼,但知识类评测落后同级模型。
这条的价值在于它把「小模型能做什么、不能做什么」标得很清楚:MATH-500 拿到 98.2,说明在结构化的推理任务上,后训练可以把 8B 级别的模型推到很高;而知识类评测的落后则暴露了参数容量对世界知识的硬约束。
为什么重要:选型时最容易犯的错是拿单项高分去推整体能力。TwIL-8B 更适合被理解为专用件——数学、代码这类有明确判定标准的任务可以放心用,开放式知识问答则不该交给它。基于 Granite 后训练也说明,基础模型生态开始出现分工:一方提供底座,一方做垂直强化。
原文:MarkTechPost
腾讯 WeVisOne-VL:一个模型包办检测、OCR、抠图重要性 5/10
微信视觉团队开源 Apache 2.0 的 WeVisOne-VL(2B/4B),统一检测、OCR、计数、分割与 alpha matting(抠图透明通道),配 9.6M 参数的像素解码器。
关键点是「统一」:这些原本各自对应专用模型的任务,被收进同一个视觉语言模型,像素解码器只用了 9.6M 参数,模型本体也控制在 2B/4B 这个小尺寸区间。
为什么重要:工程上的减负往往比跑分更有价值。文档处理、电商图、内容审核这类场景通常要串起检测、OCR、分割多个模型,每多一个模型就多一份部署、对齐和延迟成本。一个 Apache 2.0 的小模型把这些脏活覆盖掉,意味着这类流水线可以显著变短。开源许可也让它比闭源 API 更容易被嵌进私有部署。
原文:MarkTechPost
结语:今天的 8 条里,7 条在比谁更强,只有 1 条在说模型可以动手改模型——如果后者被证实,前 7 条的排名会很快失去意义。留一个问题:当模型能改写别的模型,你手里那份「权重不外流」的合规假设还成立吗?